Query augmentation nella ricerca fashion con MLP e distanza di Damerau-Levenshtein

Di recente abbiamo presentato e messo in produzione la nostra ricerca ibrida (semantica e lessicale), che funziona sia con ricerche testuali sia con ricerche tramite immagini.
Il problema: ricerche non precise
Uno dei problemi che normalmente le piattaforme di ricerca devono gestire è la risposta a ricerche non precise. Chi usa la ricerca non sempre scrive parole che rispettano la tassonomia del catalogo.
Spesso si usano parole di uso comune che non sono categorizzate nei prodotti, ad esempio "t-shirt ciclamino": il ciclamino può non essere un colore a catalogo, ma in qualche modo può essere ricondotto a qualcosa che tende al rosa o al fucsia.
Inoltre, le parole che provengono da lingue straniere, come "décolleté", spesso non vengono scritte correttamente: mancano o sono in più delle doppie, oppure mancano gli accenti.
Per ovviare a questi problemi, oltre al classico inserimento di sinonimi (una tabella che i nostri clienti, brand e partner possono popolare a mano con le alternative e le correzioni di un termine), abbiamo introdotto due strumenti che cercano di risolverli out of the box.
Il primo strumento: i typo
Il problema dei typo lo abbiamo ridotto in maniera importante completando le parole non finite con il vocabolario del catalogo, cioè le parole che i vettori sparsi (BM25) della nostra ricerca contengono: cerchiamo di capire quali sono i termini più vicini a quelli che l'utente sta cercando e, anche se non sono completi, cerchiamo di autocompletarli.
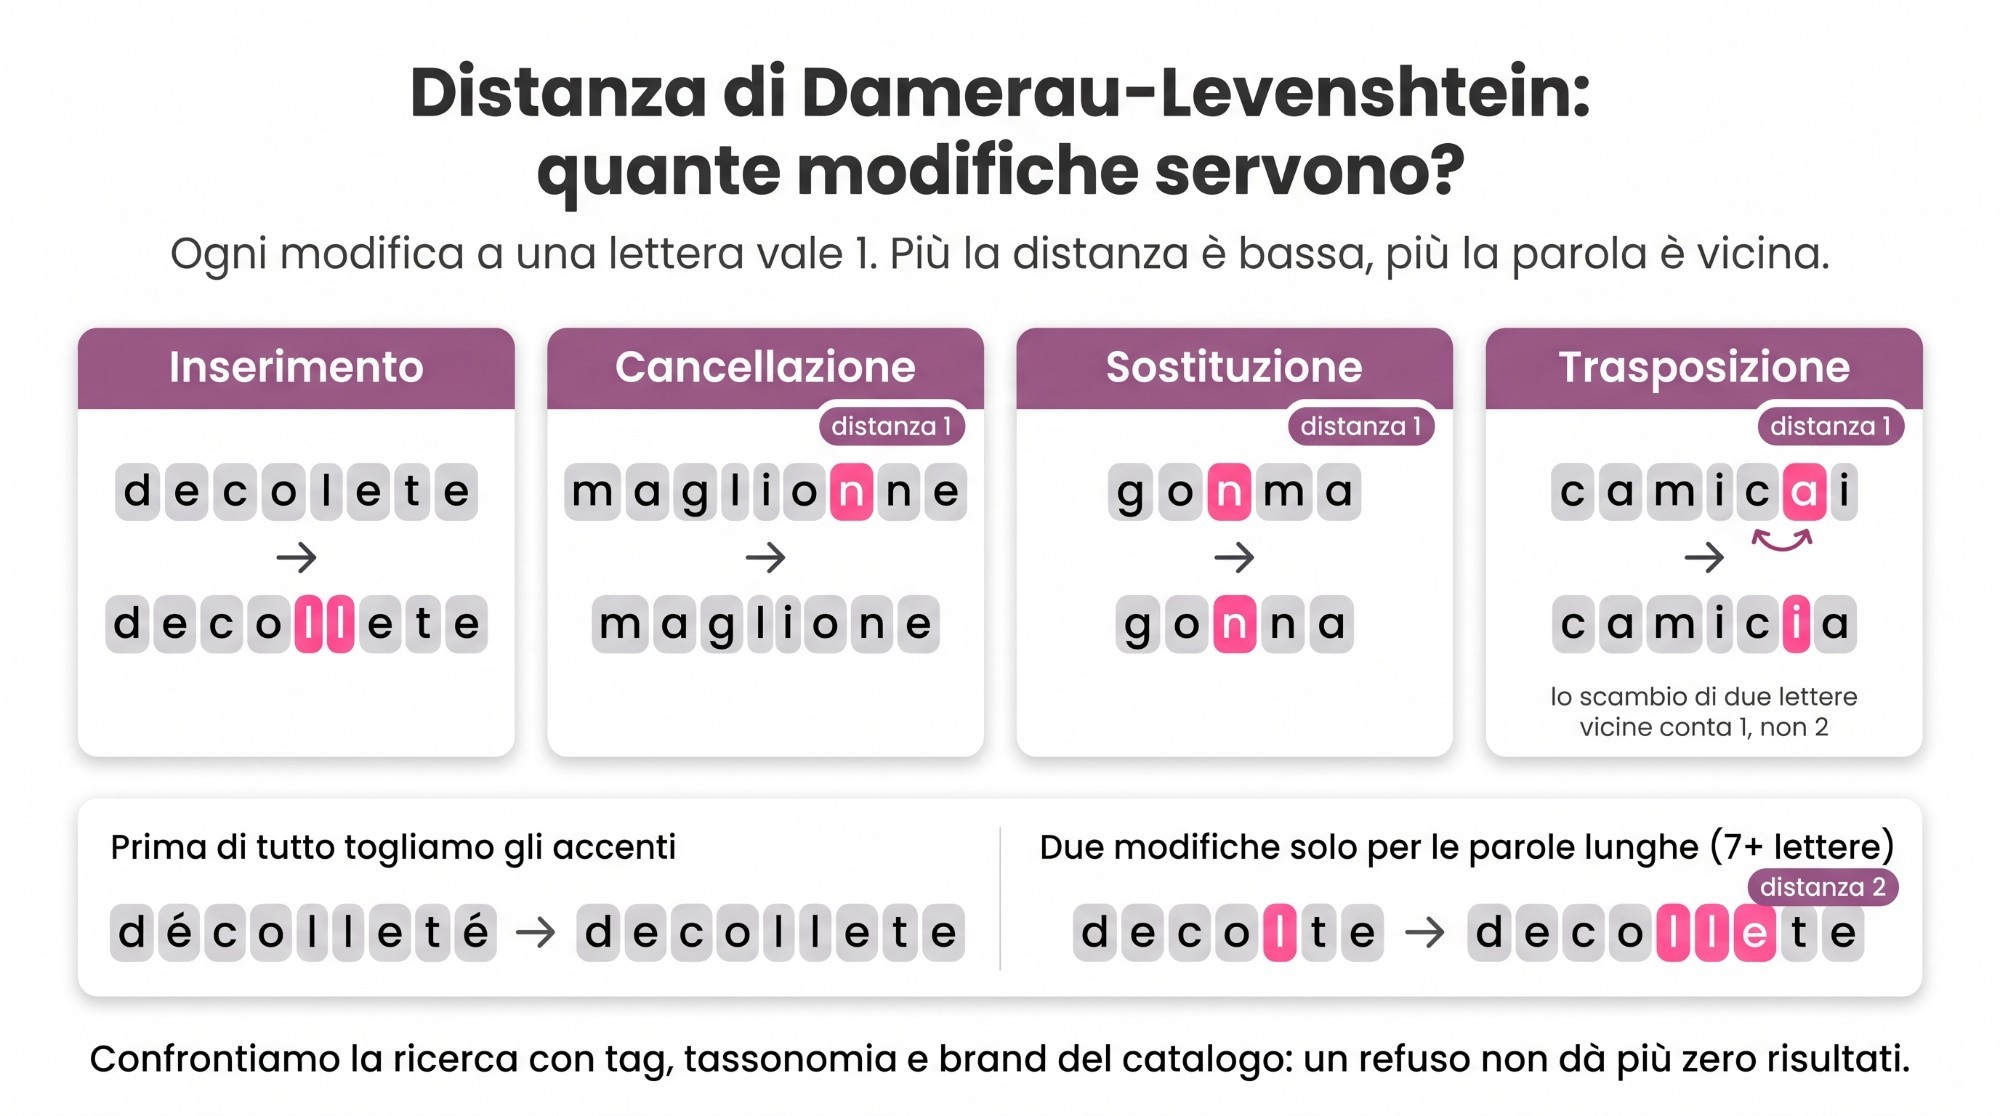
Inoltre calcoliamo la distanza di Damerau-Levenshtein tra le ricerche degli utenti e i tag, la tassonomia e i brand presenti nel nostro catalogo. In questo modo gestiamo i typo con lettere vicine che possono essere invertite, raddoppiate o ridotte, e con gli accenti eliminati. Tutto ciò che è vicino a quella ricerca, se ha una corrispondenza, lo prendiamo come buono: così un typo non limita la ricerca dando zero risultati.
La distanza di Damerau-Levenshtein conta quante modifiche servono per trasformare una parola in un'altra. Le modifiche ammesse sono quattro: inserire una lettera, toglierla, sostituirla, oppure scambiare due lettere vicine. La distanza di Levenshtein classica conosce solo le prime tre; Damerau aggiunge lo scambio, che è il refuso più comune quando si scrive di fretta: "camicai" dista 1 da "camicia", non 2. Più la distanza è bassa, più le due parole sono vicine.
Il secondo strumento: l'interpretazione
Per interpretare una ricerca abbiamo addestrato una piccola rete neurale grazie ai dati del nostro database, che raccoglie anni di outfit e di prodotti legati insieme da abbinamenti. La rete prende semplicemente in input l'embedding del testo, lo stesso vettore che la ricerca semantica già calcola, e restituisce in output dei tag affini a quel testo.
È un MLP (multilayer perceptron), molto veloce: non incide sulla velocità della ricerca stessa e non richiede l'uso di un LLM esterno.
Un MLP è la forma più semplice di rete neurale: una serie di strati di neuroni, in cui ogni neurone è collegato a tutti quelli dello strato successivo. Durante l'addestramento la rete vede migliaia di esempi e impara quali tag associare a un certo testo. Il nostro ha un solo strato nascosto: riceve i 1.536 numeri dell'embedding, li passa a 1.024 neuroni e restituisce una probabilità per ciascuno dei 557 tag. In tutto sono circa 2 milioni di parametri, contro i miliardi di un LLM: per questo risponde in un istante.

Per esempio, con "t-shirt ciclamino" cerca di capire se il ciclamino si può ricondurre a dei colori. Come dicevamo, il ciclamino può essere rosa o fucsia: la rete lo interpreta come rosa, include questo colore nella ricerca e fa salire le t-shirt rosa, cioè quelle più affini a quel colore.
In conclusione
Due strumenti, nessun LLM nel percorso della ricerca. La distanza di Damerau-Levenshtein e il completamento sul vocabolario del catalogo fanno sì che un typo o una parola non finita non diano zero risultati; l'MLP riconduce le parole di uso comune ai tag del catalogo. Entrambi lavorano sulla parte lessicale della ricerca e non aggiungono filtri: una correzione o un'interpretazione sbagliata può al massimo cambiare l'ordine dei risultati, non escluderne. E lo fanno out of the box, senza che il cliente debba definire nulla a mano.
Enrico Antonini, Deep learning engineer @Bantoa
Altri articoli dal panorama fashion-tech


Vuoi diventare il prossimo case study?
Scopri come le soluzioni Bantoa possono far crescere il tuo brand.