Filtrare le immagini indossate con la pose estimation
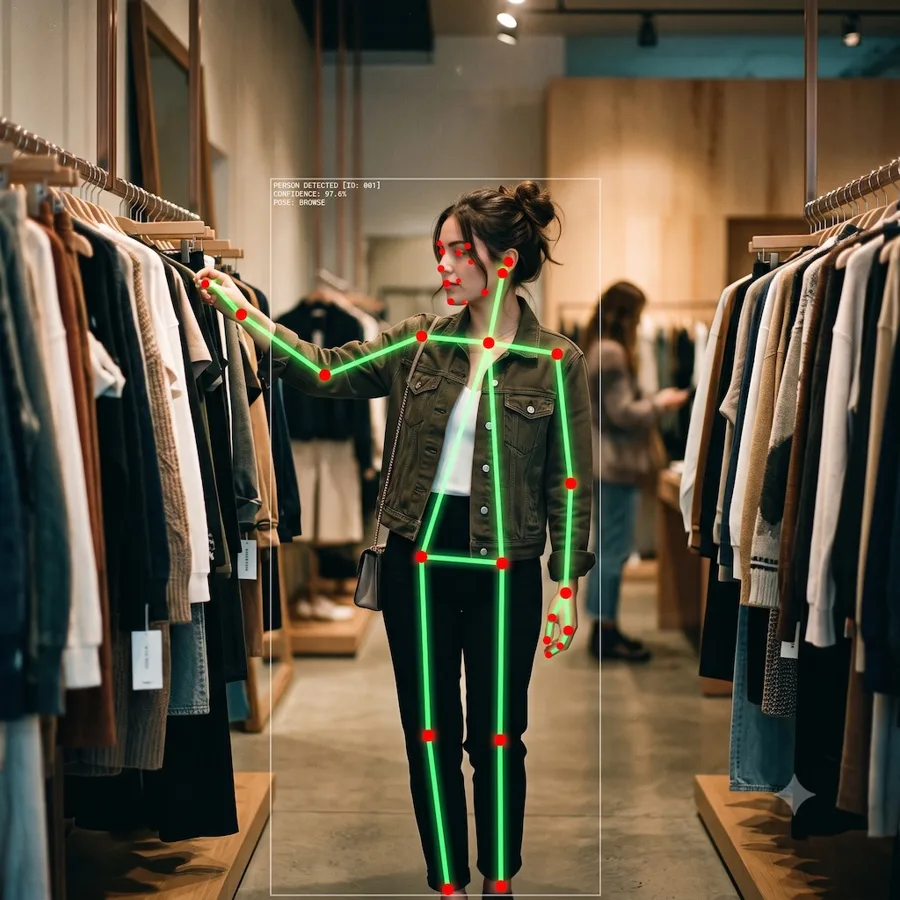
In Bantoa siamo abituati a lavorare quotidianamente con migliaia di immagini di prodotto: sono la linfa vitale della nostra piattaforma e il primo punto di contatto visivo per gli utenti. Importando cataloghi da decine di retailer differenti, ci troviamo però ad affrontare un problema di classificazione non banale.
Le immagini che riceviamo si dividono infatti in due categorie principali:
Still life: il capo è fotografato da solo, disteso su un piano o supportato da un manichino invisibile.
Indossate: il prodotto prende vita grazie a una modella o un modello che ne valorizza la vestibilità.
Spesso non abbiamo a disposizione alcuna meta-informazione che ci aiuti a discriminare la tipologia dello scatto. Questo rappresenta un ostacolo importante, poiché le immagini con modella non sono adatte a determinati casi d’uso, come la creazione di outfit visuali puliti o le funzionalità di virtual try-on.
Per risolvere il problema in maniera immediata sarebbe sufficiente inviare un prompt a un qualsiasi VLM (Vision Language Model) moderno. Tuttavia, considerando gli alti volumi di immagini con cui lavoriamo, questa strada comporterebbe costi non trascurabili e tempi di risposta che rallenterebbero drasticamente l’importazione dei prodotti.
In questo caso possiamo chiedere aiuto alla computer vision, quella branca dell’intelligenza artificiale che coinvolge algoritmi e modelli per estrarre informazioni dalle immagini. Ci sono varie soluzioni che sono state sviluppate per rilevare la presenza di oggetti specifici all’interno delle immagini, come ad esempio il modello di machine learning Haar Cascades, o la famiglia di modelli YOLO (You Only Look Once), un celebre standard nel campo della object detection e del deep learning.
In questo specifico caso, la scelta è ricaduta su una soluzione particolare: un modello di rilevamento della posa. Questi tipi di detector sono normalmente usati per tracciare i movimenti all’interno di video in real-time, ma sono perfettamente utilizzabili anche su immagini statiche, con il pregio di riuscire non solo ad identificare la presenza di un corpo umano, ma anche le sue caratteristiche, come il volto (rilevando keypoint come naso, bocca, occhi e orecchie). Un ulteriore vantaggio di questi modelli è la capacità di riconoscere dettagli anatomici anche quando sono solo parzialmente visibili. Riescono infatti a individuare gli arti nelle inquadrature di dettaglio, come nel caso di foto focalizzate unicamente su scarpe o accessori.
Nello specifico, il modello di deep learning che abbiamo scelto di utilizzare è RTMPose, su licenza Apache-2.0, formato ONNX, e abbastanza veloce su CPU: facendolo girare sull’immagine intera, abbiamo misurato ~10 ms per immagine, quindi equivalente a circa 81 immagini al secondo su una CPU di laptop.
Come funziona RTMPose
Fornendo al modello l’immagine di un capo in still life, come una t-shirt adagiata su un piano, è facile riscontrare la presenza di uno scheletro sovrapposto al tessuto. Non è un malfunzionamento, ma il normale comportamento di questo detector, progettato per individuare keypoint anatomici anche in presenza di forme che ricordano solo vagamente la silhouette umana La struttura di RTMPose è di tipo top-down. Tipicamente, questo approccio prevede una prima fase affidata a un Object Detector, il cui compito è isolare i bounding box delle persone, e una seconda fase in cui il Pose Estimator analizza esclusivamente le regioni di interesse individuate. Per ottimizzare tempi e risorse, noi abbiamo volutamente bypassato il detector iniziale, passando l’immagine intera direttamente al modello di posa.
Poiché il Pose Estimator presuppone che un primo detector abbia già isolato una persona, dà per scontato che all’interno dell’immagine ce ne sia sempre una. Una t-shirt, del resto, riflette la forma anatomica del corpo per cui è stata cucita (maniche, punto vita, scollo): il modello prova quindi a “forzare” uno scheletro plausibile seguendo le linee del tessuto. Di conseguenza, contare semplicemente i 17 keypoint della mappa derivata dal dataset COCO (Common Objects in Context) non basta a rispondere alla domanda “c’è una persona?”, proprio perché il modello ne presuppone a prescindere la presenza.
Il segnale primario e più affidabile per confermare la presenza di una persona reale rimane quindi il volto. Un capo di abbigliamento non ha la testa, quindi di conseguenza è catalogabile come oggetto. Per le foto a figura intera o mezzo busto, prendiamo quindi il punteggio più alto tra i cinque keypoint del volto (naso, occhi, orecchie) e chiediamo che superi 0,70, come soglia di confidenza. Su un set di 139 immagini verificate, considerate quindi ground truth, questa singola regola raggiunge il 97,1% di accuratezza con zero falsi positivi sulle still-life.
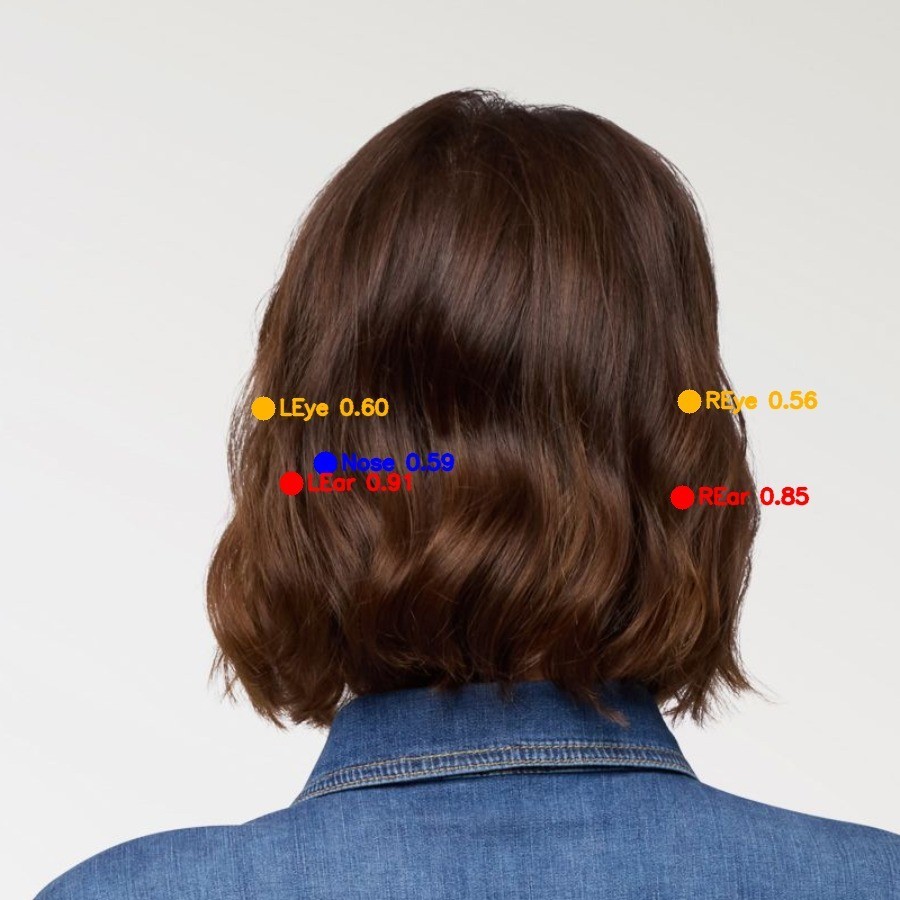
Il metodo si dimostra efficace anche negli scatti di spalle: pur senza i lineamenti del volto, il modello deduce la posizione delle orecchie dalla forma del cranio, registrando un’affidabilità molto alta (fino a 0,91) anche in presenza di capelli lunghi.
Per garantire la stabilità della regola anche con soggetti di spalle, è fondamentale considerare il valore massimo di confidence tra i cinque punti facciali e non la loro media.
Rilevare le parti: busto, gambe, dettagli
Riconoscere la presenza di una persona è tuttavia solo metà dell’opera. Per le nostre esigenze è altrettanto fondamentale identificare quali specifiche parti del corpo compaiono nell’inquadratura.
Per farlo, raggruppiamo i 17 keypoint del modello in sei regioni anatomiche principali (testa, spalle, braccia, fianchi, gambe e piedi) e verifichiamo quali superano la nostra soglia di confidence. Questo ci permette di classificare con precisione i diversi casi d’uso:
figura intera – testa, busto e gambe o piedi tutti presenti;
mezzo busto – busto senza la parte bassa;
inquadratura bassa – fianchi e gambe, con o senza piedi: è il caso di pantaloni e gonne ripresi dalla vita in giù;
solo piedi – caviglie senza il resto: tipicamente un dettaglio di scarpe.
Nel costruire questa lettura abbiamo imparato due cose che vale la pena sapere:
un punteggio alto non garantisce che il keypoint sia nell’immagine. In una foto tagliata a metà coscia, RTMPose piazzava entrambe le ginocchia sotto il bordo inferiore, a oltre 1100 pixel su un’immagine alta 1138, con punteggio 0,8. Il modello intuisce la traiettoria degli arti visibili e “indovina” matematicamente dove dovrebbero trovarsi i giunti mancanti, a prescindere dai limiti fisici della foto. Per distinguere una figura intera da un mezzo busto, quindi, bisogna guardare le coordinate spaziali per assicurarsi che i punti cadano dentro l’immagine, non solo la loro confidenza.
Nei dettagli ravvicinati (es. le scarpe) dove la testa è tagliata fuori e la regola del volto > 0,70 fallirebbe inevitabilmente. Su un crop molto stretto tutti i punteggi si abbassano insieme, e una soglia fissa smette di vedere qualsiasi cosa. L’ordine relativo però sopravvive: in una foto di scarpe le caviglie battono nettamente il volto. In questi casi specifici, dove le coordinate ci confermano che la parte superiore del corpo è fuori dai bordi, confrontiamo le due metà dello scheletro tra loro invece che affidarci a una costante assoluta. Questo ci permette di validare le inquadrature basse aggirando l’assenza del volto, evitando al contempo che una semplice borsa isolata venga scambiata per una foto indossata (poiché la borsa attiverebbe dei keypoint casuali senza rispettare la rigorosa coerenza spaziale e relativa che richiediamo).

Sebbene un modello di pose estimation top-down nasca per tracciare le articolazioni dando per scontata la presenza di una persona, abbiamo dimostrato che, se interrogato con la giusta logica, può trasformarsi in un eccellente sistema di body detection.
Sfruttando con criterio i punteggi di confidence (usando il volto come ancora principale) e verificando la coerenza delle coordinate spaziali per i dettagli ravvicinati, siamo riusciti ad adattare l’output del modello alle nostre esigenze. Il risultato è un detector che non si limita a confermare la presenza di una persona, ma descrive con precisione quali parti anatomiche sono inquadrate, permettendoci di scartare i manichini e categorizzare i crop. Il tutto direttamente su CPU, in appena una decina di millisecondi per immagine e, soprattutto, risolvendo un problema reale di e-commerce senza dover addestrare alcun modello custom.
Fonti
RTMPose (MMLab): https://github.com/open-mmlab/mmpose/tree/main/projects/rtmpose
RTMPose: Real-Time Multi-Person Pose Estimation based on MMPose (paper): https://arxiv.org/abs/2303.07399
COCO Dataset: https://www.cocodataset.org/
Microsoft COCO Common Objects in Context (paper): https://arxiv.org/abs/1405.0312
Enrico Antonini, Deep learning engineer @Bantoa
Altri articoli dal panorama fashion-tech


Vuoi diventare il prossimo case study?
Scopri come le soluzioni Bantoa possono far crescere il tuo brand.