Il sarto digitale: come SAM 3 ritaglia i garment dalle immagini

Lo scorso mese abbiamo visto come un pose detector, RTMPose, riesce ad aiutarci nell’andare a rilevare le immagini con i capi realmente indossati, qui il link all’articolo.
Le immagini con capi indossati non possono essere usate per creare outfit sulla nostra Social App. Questo perché sono indossate e potrebbero essere state scattate da diverse angolazioni. Anche le immagini di dettaglio del prodotto stesso, che di solito vengono scartate, rientrano in questa categoria.
Esistono però servizi che offriamo ai nostri clienti, come la Visual Search, basati su una RAG che restituisce i prodotti simili o abbinabili: in quel caso specifico, avere più immagini e scattate con prospettive diverse, che siano indossate e non, sono per noi un valore. Come possiamo però “ripulirle” per andare ad isolare soltanto il garment, ignorando il background, ma soprattutto scartando la persona che lo sta indossando?
Object detection con il deep learning
Negli ultimi anni, l’evoluzione delle VLM ha portato parecchi benefici nel contesto della computer vision, per cui banalmente ci si potrebbe porre la domanda: mi basta una chiamata verso ad esempio un GPT-5.x? – In questo caso no: per una questione di costi e limitazioni, non è propriamente lo strumento adatto.
Un potente VLM è in grado di isolare i garment, restituendoci i bounding boxes, ovvero le coordinate nelle quali è collocato il prodotto all’interno dell’immagine, in una maniera molto simile ai modelli convoluzionali (CNN), come YOLO 26. Tuttavia, anche se rimane un metodo valido per isolare un capo di abbigliamento all’interno di una foto, anche full-body, non ci restituisce qualcosa di perfettamente pulito ed esente da sfondi o da persone.
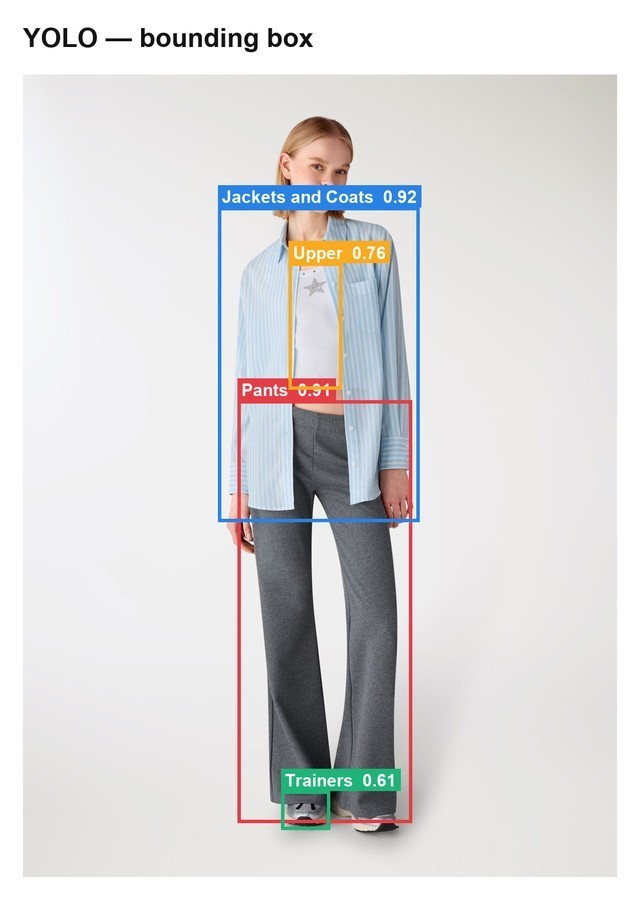
Per “ritagliare” il prodotto ci serve quindi un modello di segmentazione che non si limiti a rilevarlo indicandoci dove è collocato, ma che riesca a isolarlo ed estrarlo in maniera precisa generando una maschera. Se è vero che per questo task un VLM è poco adatto, è anche vero che la parte di architettura transformer nei modelli di segmentazione è stata fondamentale per l’evoluzione di questo tipo di computer vision.
Segment Anything Model
Uno dei più famosi modelli di deep learning di segmentazione si chiama SAM, Segment Anything Model, ed è stato sviluppato da Meta nel 2023. La prima versione ha avuto molto successo e gli è succeduta una seconda versione (SAM2) nel 2024, che ne aumenta la precisione, tanto da poter essere usato real-time sui video e da segmentare diversi oggetti nella stessa scena. Per quanto la bontà dell’output dei due modelli SAM sia ottima, non è facilmente integrabile in un flusso personalizzato, in quanto operano in modalità point-to-segment, ovvero necessitano in input di un target visivo, ad esempio di coordinate di un punto dell’area da segmentare. Nel novembre 2025 Meta ha rilasciato una nuova versione del modello, denominata SAM3, che evita completamente queste dinamiche grazie a un encoder testuale al posto del point-to-segment: è stato sviluppato addestrandolo con un open vocabulary ed è quindi sufficiente specificare una keyword per indicare al modello l’oggetto da segmentare. Che bastino le parole non vuol dire però che vada bene qualsiasi parola. Il vocabolario di SAM 3 è visivo, non commerciale: t-shirt, jeans o giacca li riconosce senza problemi, ma i nomi con cui distinguiamo un modello dall’altro a catalogo, per lui spesso non significano niente.
Qui si cela il vero problema: se il modello non riconosce il termine, non restituisce alcun errore. Ripiega silenziosamente su un concetto più generico, generandoti comunque una maschera, ma del capo sbagliato. Per questo abbiamo smesso di interrogarlo con il tipo di prodotto e siamo passati alla zona del corpo: upper clothing, lower clothing, shoes. Si tratta di un’informazione meno specifica, ma molto più affidabile, perché la dove il tipo funzionava, la zona restituisce esattamente lo stesso ritaglio; dove falliva, lo recupera.
Il processo si basa su un perception encoder, che combina un encoder visivo transformer (ViT) dotato di windowed attention (in stile SAM2) e un encoder testuale. I dati così elaborati passano a un modello di rilevamento, che individua gli elementi target nell’immagine e ne genera la maschera.

Un servizio su misura
SAM3 non è un modello LLM, ed è quindi (molto) meno esigente in fatto di requisiti hardware per l’inferenza. È ospitato su diverse piattaforme che lo mettono a disposizione tramite semplici chiamate REST, come fal.ai; noi, tuttavia, abbiamo preferito sviluppare una soluzione più in linea con le nostre esigenze.
Grazie a RunPod, abbiamo containerizzato SAM3 e sviluppato un layer che potesse gestire l’inferenza con una serie di keyword predefinite, sia one-shot sia batch. Questo è stato possibile grazie alla configurazione di un endpoint serverless, che fornisce accesso a GPU performanti solo nel caso in cui serva effettivamente l’inferenza, comportando una notevole riduzione dei costi.
A questo punto, avendo un servizio personalizzato e configurato per noi, abbiamo potuto utilizzarlo in vari modi:
Isolare i capi worn: da una foto indossata la maschera estrae ogni capo, separato dal corpo e dagli altri capi.
Ripulire gli still life: uno still life è per il 57-87% fondale di studio: si indicizza il capo, non lo sfondo.
Alimentare il vector database: possiamo sfruttare il prodotto segmentato con precisione per l’ingestion, creando gli embeddings per i prodotti con le immagini indossate, che hanno un diverso peso rispetto alle immagini still-life.
Estrazione degli atributi: isolando accuratamente il garment, possiamo calcolarne il colore predominante e categorizzarlo secondo la nostra tassonomia.
Live: l’utente carica una worn e clicca sul capo estratto: quel ritaglio diventa la query.
Cinque diversi usi ma un servizio solo: è questo che ha reso SAM 3 il nostro coltellino svizzero. È stato introdotto e sviluppato per un compito preciso, ovvero togliere la modella e il fondale da una fotografia, ma grazie alla sua versatilità e precisione, dopo una nostra personalizzazione, siamo stati in grado di integrarlo in più ambiti e operazioni.
Il merito non è di una funzione in particolare, ma della forma del modello: non gli si insegna un catalogo di categorie una volta per tutte, gli si dice a parole cosa cercare, ed è per questo che la stessa chiamata ha finito per rispondere a domande che non avevamo in mente quando l’abbiamo costruita. Bisogna però imparare a maneggiarlo: se gli chiedi qualcosa che non sa vedere, una risposta te la dà lo stesso, ed è sbagliata.
Ma è quello che si dice di ogni buon attrezzo, nelle mani giuste taglia qualsiasi cosa, e per un sarto digitale non c’è complimento migliore.
Fonti
SAM3: https://github.com/facebookresearch/sam3
SAM3 (paper): https://ai.meta.com/research/publications/sam-3-segment-anything-with-concepts/
RunPod: https://www.runpod.io/
Enrico Antonini, Deep learning engineer @Bantoa Alberto Dosso, BSc intern @Bantoa
Altri articoli dal panorama fashion-tech


Vuoi diventare il prossimo case study?
Scopri come le soluzioni Bantoa possono far crescere il tuo brand.