Diffusion models: come il deep learning “veste” le immagini
Sempre più spesso, sentiamo parlare di generazione, editing e a volte persino contraffazione di immagini tramite intelligenza artificiale. Ma come funzionano davvero questi modelli?
I modelli di deep learning usati per creare o elaborare immagini sono molto diversi dai classici modelli di linguaggio naturale (come GPT 5.5, Gemini 3.1 o Opus 4.8). Molti strumenti noti, come Stable Diffusion e Midjourney, si basano sui diffusion model: modelli che imparano a generare immagini attraverso un processo progressivo di distruzione e ricostruzione. I modelli più recenti, come Gemini Flash Image (a.k.a. Nano Banana) o GPT-image, hanno però adottato strade in parte diverse: il loro funzionamento è piuttosto complesso, ma capirne il meccanismo alla base aiuta a leggerne con più chiarezza potenzialità e limiti.
I diffusion model sono modelli generativi: servono a creare dati, nel nostro caso immagini, simili a quelli con cui sono stati addestrati. La loro logica è quasi controintuitiva: durante l’addestramento, i modelli imparano prima a degradare progressivamente le immagini aggiungendo rumore, fino a ridurle a puro “disturbo”, simile a quello delle vecchie TV a tubo catodico senza segnale. Poi imparano a compiere il percorso inverso: partire da una rappresentazione rumorosa e rimuovere il rumore passo dopo passo, fino a ricostruire un’immagine coerente.
Nel momento in cui le immagini vengono scomposte, distrutte e poi ricreate, la domanda centrale diventa: quale valore produce davvero questo processo?
Il conditioning: dove nasce il virtual try-on
La risposta sta in una parola: conditioning.
La parte interessante arriva durante la ricostruzione: è qui che il modello può essere “condizionato” e guidato verso un risultato specifico. Questo apre la strada ad applicazioni come il virtual try-on, che permettono di ottenere in pochi passaggi risultati che, fino a poco tempo fa, richiedevano competenze grafiche avanzate.
I modelli più evoluti accettano in input più immagini (la foto della modella su cui “applicare” il capo e la foto del capo stesso) insieme a un testo che guida la ricostruzione. Ecco allora che un modello guidato da un prompt non si limita solamente a ricostruire un’immagine: può generare un risultato con caratteristiche ben definite, adattando il capo alla modella in modo credibile. Nel caso del virtual try-on, questo significa rispettare elementi come la vestibilità, la silhouette, le proporzioni, la caduta del tessuto e il modo in cui l’indumento interagisce con il corpo.
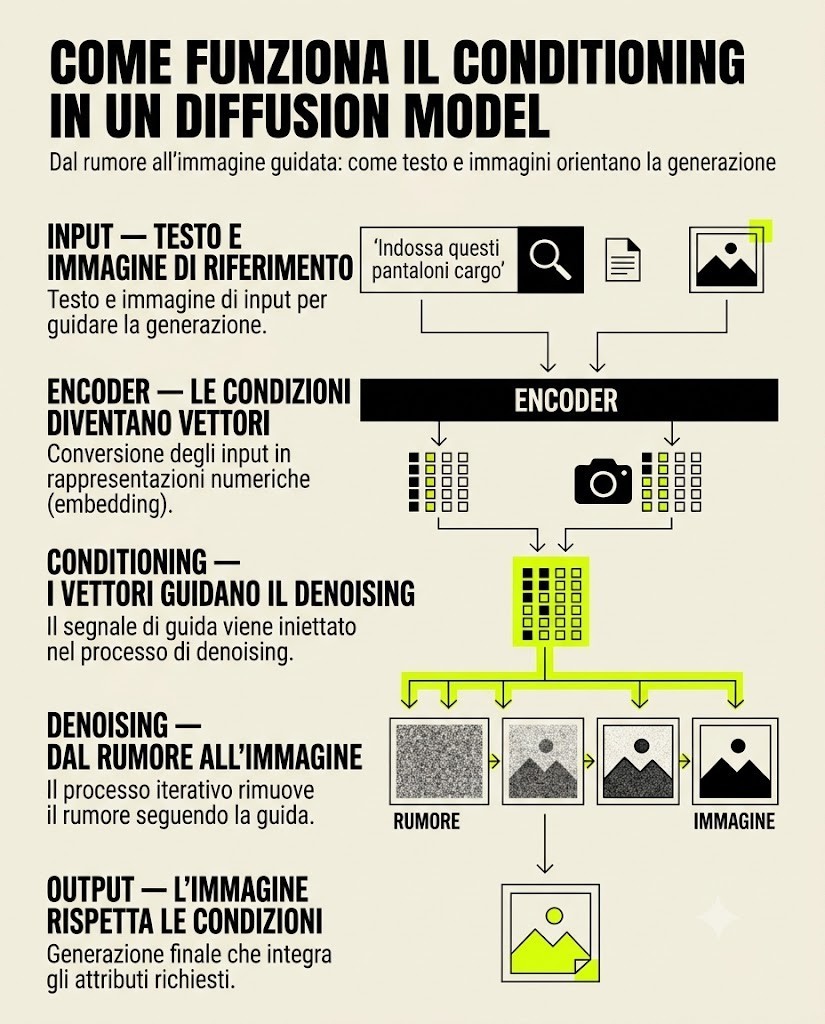
Sul piano più tecnico, i nomi cambiano a seconda del tipo di modello. Nei diffusion model classici (come Stable Diffusion) l’operazione di distruzione si chiama forward, mentre la ricostruzione si chiama denoising, proprio perché “toglie” il rumore passo dopo passo.
L’aggiunta di testo e immagini serve a guidare il processo di denoising attraverso il conditioning. In questa fase, i contenuti condizionanti, come il prompt testuale o le immagini di riferimento, vengono codificati in rappresentazioni numeriche, cioè embedding, che il modello può interpretare. Il modello parte da una rappresentazione rumorosa e, step dopo step, la aggiorna per ottenere un’immagine sempre più definita. A ogni passaggio, gli embedding del prompt e dei riferimenti visivi orientano la ricostruzione, indicando al modello quali elementi mantenere, quali caratteristiche rispettare e verso quale risultato convergere. È così che testo e immagini di riferimento influenzano progressivamente l’immagine mentre emerge dal rumore.
Non tutti i modelli sono diffusion model
A questo punto è importante fare una precisazione: non tutti i generatori di immagini sono diffusion model. Esistono anche modelli autoregressivi, che lavorano “a token” come gli LLM (generano l’immagine un pezzo alla volta, come ChatGPT genera il testo parola dopo parola), e modelli ibridi, che fondono generazione autoregressiva e diffusion.
Si ritiene che a quest’ultima famiglia appartengano i modelli Google Gemini Flash Image, comunemente noti come Gemini Flash Image, così come la generazione immagini di OpenAI (GPT-image). Il punto fondamentale, però, non cambia: anche nella generazione autoregressiva i contenuti in input, immagini e testo, condizionano l’output, perché vengono trasformati in token. Il come cambia (denoising guidato vs generazione di token guidata), ma il principio del conditioning resta lo stesso.
Il test: modello dedicato vs modello condizionabile
Per capire cosa cambia nella pratica, abbiamo messo a confronto due approcci sullo stesso compito, vestire una modella con un determinato capo:
un modello dedicato e “chiuso”: Google Vertex AI Virtual Try-On (virtual-try-on-001), che accetta solo immagini (foto della persona + foto del prodotto), senza prompt testuale;
modelli generali e condizionabili: Gemini 3.1 Flash Image e GPT-image-2, che accettano immagini e testo, e che quindi possiamo guidare per migliorare, ad esempio, la vestibilità di un capo.
L’asse del confronto è proprio questo: da una parte un modello specializzato (input solo immagini, compito fisso, nessuna possibilità di guidarlo a parole); dall’altra un modello generalista e pilotabile (immagini + testo), più flessibile ma meno specializzato e da istruire con cura.

Nel primo caso possiamo vedere come il modello di try-on di Vertex abbia correttamente sostituito i jeans della nostra modella con i pantaloni cargo dell’immagine still-life, mantenendo i dettagli delle tasche, le etichette del brand e l’effetto delavé. Dall’immagine, tuttavia, si nota che la vestibilità non è stata rispettata: il pantalone cargo ha assunto la stessa forma del jeans originale, invece della propria.

Nel secondo caso, invece, Nano Banana 2 (il modello Gemini 3.1 Flash Image) – potendo essere guidato anche dal testo – ha adattato i pantaloni cargo con una vestibilità realistica, rispettando la silhouette propria del capo, compresa la naturale ricaduta dell’orlo dei pantaloni sulla scarpa, e con variazioni minime nella luminosità della modella.
In conclusione, il virtual try-on è passato dall’essere un’operazione manuale e costosa a una tecnologia alla portata di chiunque sappia come guidarla.
Che si scelga un modello dedicato come Vertex AI o uno generalista e condizionabile come Nano Banana, il principio resta lo stesso: dietro a un risultato convincente c’è sempre un buon conditioning, fatto di immagini e testo che orientano il modello passo dopo passo.
Per chi lavora nella moda e nell’e-commerce questo significa mostrare un capo addosso a una modella in pochi secondi, senza uno shooting dedicato, un vantaggio concreto, a patto di conoscerne anche i limiti.
Enrico Antonini, Deep learning engineer @Bantoa
Altri articoli dal panorama fashion-tech


Vuoi diventare il prossimo case study?
Scopri come le soluzioni Bantoa possono far crescere il tuo brand.